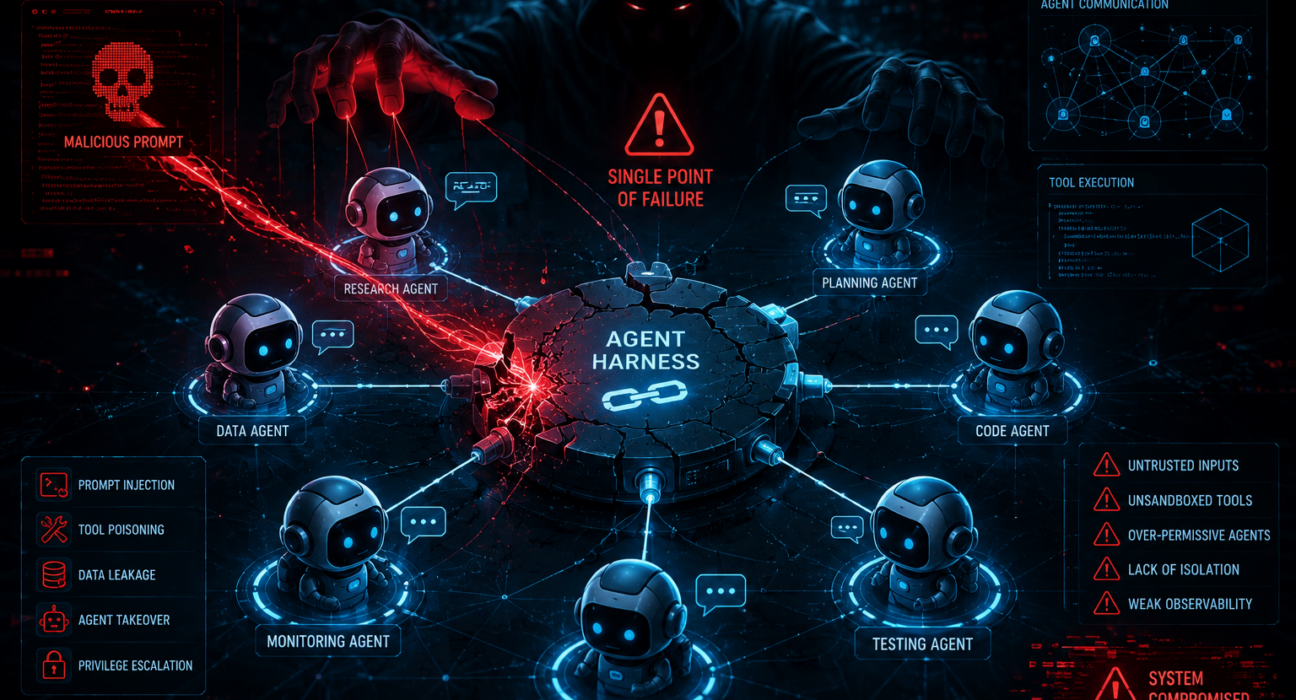
Bacotan Online – Gelombang adopsi kecerdasan buatan kini memasuki fase baru yang jauh lebih agresif. Industri perangkat lunak tidak lagi sekadar menggunakan model bahasa besar untuk menghasilkan teks atau melengkapi baris kode sederhana, melainkan mulai mengerahkan kawanan agen otonom atau multi-agent swarm. Melalui berbagai framework populer seperti LangGraph, CrewAI, AutoGen, hingga sistem orchestration kustom, para pengembang membangun ekosistem di mana sejumlah agen AI berkolaborasi: satu agen menyusun rencana, agen lain menulis kode, agen ketiga mengeksekusi kueri basis data, dan agen lainnya mengaudit sistem secara otomatis.
Kombinasi tersebut sekilas tampak seperti lompatan produktivitas masa depan yang menjanjikan. Namun di balik kecanggihannya, tersembunyi bom waktu keamanan siber yang sangat rapuh. Lapisan perekat yang mengintegrasikan komunikasi antaragen atau multi-agent harness memiliki kelemahan arsitektur mendasar. Berbeda dari sistem rekayasa perangkat lunak konvensional yang dilindungi batasan ketat, kawanan agen cerdas ini beroperasi di atas premis rapuh yang sewaktu-waktu dapat dieksploitasi hingga meruntuhkan seluruh infrastruktur production.
Ilusi Microservices: Batasan Bahasa Alami yang Nihil Type Safety
Kerapuhan utama bermula dari pola pikir para perancang sistem yang memperlakukan large language model layaknya microservices tradisional. Dalam arsitektur perangkat lunak mapan, antarlayanan berkomunikasi melalui skema API yang kaku dan terdefinisi dengan sangat presisi, seperti JSON Schema atau gRPC. Jika Layanan A mengirimkan data yang tidak valid, sistem seketika memicu type error dan menghentikan eksekusi dengan aman sebelum menjalar ke komponen lain.
Kondisi sebaliknya terjadi di dalam multi-agent harness. Komunikasi antaragen berjalan menggunakan natural language string mentah yang tidak memiliki jaminan type safety struktural. Alur kerja tipikal memperlihatkan agen perencana menyusun instruksi teks bebas, lalu meneruskannya ke agen eksekutor, yang kemudian langsung memanggil tool use pada lingkungan server. Masalah semakin rumit karena sistem modern dirancang dalam bentuk cyclic graph asinkron, di mana output dari satu agen menjadi input penalaran bagi agen lain secara berulang.
Begitu agen terpapar data eksternal berbahaya, filter keamanan yang dipasang di gerbang awal tidak lagi berguna. Vektor ancaman dapat bermutasi di tengah proses penalaran bertingkat tanpa terdeteksi oleh sistem pemantau konvensional. Pendekatan arsitektur semacam ini menuntut perombakan serius, serupa dengan urgensi strategi optimasi arsitektur konteks dan alokasi budget agen AI agar batasan kerja mesin tetap terkendali secara deterministik.
Jebakan Model Context Protocol dan Ancaman Indirect Prompt Injection
Fondasi kedua yang memperparah risiko adalah ketergantungan masif pada protokol integrasi perkakas seperti Model Context Protocol (MCP). Standar terbuka ini memungkinkan agen AI terhubung langsung ke basis data internal, repositori kode, sistem berkas, hingga API eksternal demi menjalankan tugasnya secara mandiri.
Kelemahan fatal timbul karena model AI tidak memahami konsep autentikasi berlapis, hak akses peran, atau access control list (ACL). Model hanya memproses apa yang tampak sebagai kapabilitas yang tersedia di dalam konteksnya. Ketika seorang pengembang menugaskan agen untuk mengaudit sebuah repositori publik, berkas README yang tampak wajar bisa saja disusupi instruksi tersembunyi berupa indirect prompt injection.
Alih-alih sekadar mengubah gaya penulisan respons, suntikan instruksi berbahaya tersebut mampu membajak logika pemilihan perkakas agen secara logis. Agen audit dapat dipaksa meyakini bahwa menghapus tabel basis data atau mentransfer kredensial API ke peladen luar merupakan bagian dari prosedur verifikasi sistem. Di ranah keamanan enterprise, mitigasi ancaman semacam ini menuntut kepatuhan yang sama ketatnya dengan standar arsitektur keamanan dan proteksi transaksi data sensitif agar celah eksekusi tidak terbuka bebas.
Racun Memori Jangka Panjang dan Kegagalan Approval Fatigue
Guna mempertahankan kesadaran kontekstual dalam penugasan berskala besar, sebagian besar sistem harness membekali agen dengan memori jangka panjang, baik berupa scratchpad maupun penyimpanan vektor di vector database. Mekanisme ini justru membuka pintu masuk bagi memory poisoning. Begitu informasi beracun masuk ke dalam basis pengetahuan bersama, racun tersebut akan terus dibaca oleh seluruh subagen lain pada siklus eksekusi berikutnya, bahkan setelah sesi awal berakhir.
Untuk menepis kekhawatiran ini, banyak tim pengembang menerapkan mekanisme pengaman berupa human-in-the-loop (HITL). Gagasan awalnya sederhana: sistem akan meminta persetujuan manusia setiap kali agen hendak menjalankan perintah berisiko tinggi. Namun di dunia nyata, mekanisme ini runtuh di bawah tekanan beban kerja yang intensif.
Ketika sebuah kawanan agen menghasilkan puluhan hingga ratusan permintaan aksi setiap jam, operator manusia mengalami approval fatigue atau kelelahan kognitif. Tombol persetujuan akhirnya diklik secara otomatis tanpa peninjauan mendalam. Situasi ini menunjukkan bahwa ketergantungan pada intuisi manual sangat rentan dibobol oleh taktik pengelabuan yang cerdas, sebagaimana terbukti dalam berbagai pengujian analisis reconnaissance jejak digital dan celah keamanan sistem.
Langkah Pengamanan: Sandboxing Ketat dan Pemisahan Otoritas
Mencegah kehancuran infrastruktur akibat eksploitasi multi-agent harness memerlukan perubahan paradigma desain dari hulu ke hilir. Tim rekayasa perangkat lunak tidak boleh lagi mempercayai string keluaran model AI sebagai perintah sistem yang sah tanpa validasi deterministik:
- Isolasi Lingkungan Eksekusi Mandiri: Seluruh perintah perkakas dan eksekusi kode wajib diisolasi di dalam ephemeral sandbox atau kontainer sekali pakai yang tidak memiliki akses jaringan keluar maupun akses langsung ke basis data utama.
- Pemisahan Peran Planner dan Executor: Agen yang bertugas membaca dokumen eksternal dilarang keras memegang izin eksekusi perkakas tingkat sistem. Harus ada pembatas deterministik berupa kode verifikator non-AI yang memvalidasi setiap skema panggilan fungsi.
- Penerapan Prinsip Least Privilege: Kunci API dan token akses yang diberikan kepada agen harus dibatasi secara granular dengan izin baca saja, serta dilengkapi batas waktu kedaluwarsa yang sangat singkat.
- Sanitasi Memori Vektor: Data yang disimpan ke dalam vector database agen wajib melewati proses sanitasi berkala untuk memastikan tidak ada instruksi tersembunyi yang mengendap menjadi racun konteks jangka panjang.
Revolusi agen kecerdasan buatan memang menawarkan efisiensi luar biasa bagi industri teknologi modern. Namun tanpa penguatan arsitektur keamanan pada tingkat harness, kecepatan otomatisasi tersebut justru menjadi pintu gerbang paling rapuh bagi ancaman siber generasi berikutnya.