Bacotan Online – Mengoperasikan autonomous AI coding agent untuk menangani siklus rekayasa perangkat lunak secara mandiri—mulai dari perbaikan kutu kode, refaktorisasi, hingga pembukaan pull request otomatis—kini menjadi standar baru di berbagai tim pengembang modern. Namun, lonjakan produktivitas tersebut kerap dibarengi lonjakan biaya komputasi yang tak terduga. Menjalankan agen otonom sepanjang hari dapat membakar kuota paket langganan dan saldo token API dalam sekejap. Respon umum terhadap masalah ini biasanya adalah menaikkan paket langganan ke jenjang lebih mahal. Padahal, solusi yang jauh lebih cerdas dan berkelanjutan adalah merombak arsitektur agen agar berhenti membuang token secara percuma.
Anatomi Pemborosan Token pada Sistem Agen Otonom
Banyak pengembang tidak menyadari bahwa arsitektur prompt yang tidak efisien dapat melipatgandakan konsumsi token secara eksponensial. Dalam siklus kerja agen otonom, setiap interaksi baru akan membaca ulang seluruh riwayat konteks sebelumnya. Ketika agen ditugaskan menyelesaikan satu tiket, instruksi konfigurasi awal sering dimuat utuh bersama puluhan aturan tambahan yang belum tentu relevan dengan masalah yang sedang dipecahkan.
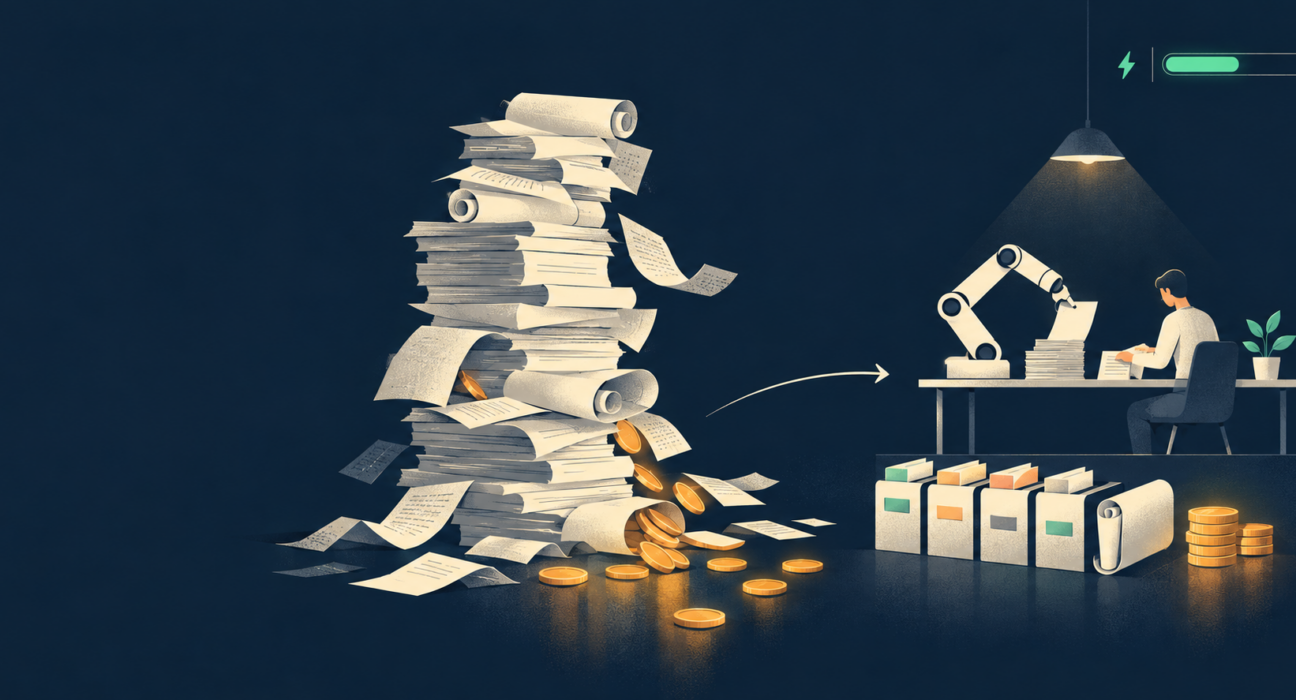
Kondisi ini diperparah oleh kebiasaan agen yang mengembalikan laporan proses kerja bertele-tele. Setiap kali subagent melaporkan hasil kerjanya kepada agen induk dengan menyalin log eksekusi terminal, rincian pengujian yang berhasil, atau catatan analisis panjang, seluruh teks tersebut menetap di dalam jendela konteks (context window). Akibatnya, pada setiap giliran berikutnya, agen induk membayar biaya komputasi untuk membaca ulang informasi historis yang sebenarnya sudah tidak diperlukan.
Visibilitas Metrik Sebelum Eksekusi Pemotongan
Langkah fundamental dalam menekan pemborosan adalah membangun visibilitas konsumsi secara langsung. Sering kali pengembang baru memeriksa penggunaan token ketika batas kuota hampir habis atau ketika sistem tiba-tiba menolak permintaan akibat terbentur rate limit. Mengintegrasikan pemantauan metrik penggunaan langsung pada bilah menu desktop atau terminal kerja memberikan umpan balik langsung mengenai efisiensi setiap sesi kerja.
Dengan memantau dua indikator utama—utilisasi jangka pendek (jendela pemakaian 5 jam) dan utilisasi jangka menengah (akumulasi 7 hari)—pengembang dapat segera mendeteksi lonjakan anomali setelah sebuah tiket selesai dieksekusi. Visibilitas ini menjadi kompas yang menunjukkan di bagian alur kerja mana pemborosan terbesar terjadi, sehingga intervensi perbaikan dapat diarahkan secara tepat sasaran.
Penerapan Arsitektur Progressive Disclosure pada Berkas Konfigurasi
Penyumbang pemborosan terbesar dalam ekosistem agen bersumber dari berkas konfigurasi instruksi monolitik. Sering ditemukan sebuah berkas aturan atau modul keahlian (skill file) berukuran puluhan kilobita yang memuat seluruh pedoman proyek, mulai dari arsitektur basis data hingga prosedur penanganan insiden darurat. Ketika berkas ini dimuat pada setiap pemanggilan, ribuan token terbuang sia-sia hanya untuk membaca instruksi yang tidak dieksekusi.
Solusi arsitektural yang paling efektif adalah menerapkan prinsip progressive disclosure. Pisahkan berkas instruksi utama menjadi berkas gerbang masuk berukuran ringkas, lalu pindahkan dokumentasi rujukan teknis mendalam ke dalam berkas terpisah yang hanya dipanggil sesuai kebutuhan spesifik. Pendekatan isolasi konteks ini sejalan dengan prinsip kebersihan sistem perangkat lunak, sebagaimana pentingnya disiplin sanitasi log dan stripping bytecode agar tidak mencemari lingkungan eksekusi dengan data mentah yang tidak terpakai.
Dengan metode ini, teks instruksi yang wajib dibaca pada setiap sesi dapat dipangkas drastis hingga lebih dari 70 persen. Sebagian besar materi yang dihapus berupa pengulangan aturan dalam kalimat berbeda, penanganan skenario ekstrem yang jarang terjadi, atau instruksi defensif yang berlebihan.
Segmentasi Tugas dan Kolaborasi Alur Kerja Terbagi
Pendekatan agen tunggal serba bisa untuk menangani segala jenis tugas terbukti menjadi pemborosan besar. Agen yang memuat instruksi penanganan kutu kode (bug fix), penambahan fitur baru, pemeliharaan rutin, hingga pengujian integrasi sekaligus akan membawa beban instruksi yang berat di setiap putaran tugas.
Strategi yang jauh lebih efisien adalah memecah agen monolitik menjadi agen terspesialisasi berdasarkan domain pekerjaan. Sebagai contoh, agen perbaikan kutu kode dipisahkan dari agen pembangun fitur baru. Keduanya kemudian memanfaatkan modul alur kerja bersama untuk fase-fase umum seperti pembuatan worktree, eksekusi pengujian, dan pembukaan pull request. Mekanisme perutean (routing) dijalankan di awal proses untuk menentukan target agen sebelum operasi berat dimulai, sehingga tidak ada siklus komputasi terbuang di tengah jalan.
Penerapan Model Multi-Tier Sesuai Bobot Kognitif
Menggunakan model kecerdasan buatan kelas teratas dengan biaya tertinggi untuk seluruh tahapan kerja—mulai dari perancangan arsitektur hingga penulisan kode templat standar dan pembacaan log—adalah inefisiensi finansial yang nyata. Kunci optimalisasi biaya tanpa penurunan mutu adalah menerapkan strategi pembagian tingkat model (model tiering) yang disiplin.
Alokasikan model terkuat dengan kemampuan penalaran tinggi khusus untuk perancangan solusi tingkat tinggi, diagnosis masalah rumit, dan gerbang validasi akhir. Untuk tugas eksekusi penulisan kode, perbaikan sintaksis, dan pengujian unit, delegasikan pekerjaan kepada model kelas menengah yang jauh lebih hemat dan cepat. Sementara itu, tugas mekanis ringan seperti peringkasan teks atau pemformatan keluaran dapat diserahkan kepada model terkecil.
Namun, pengembang dilarang menurunkan kelas model pada gerbang pengambilan keputusan kritis. Evaluasi kelayakan kode sebelum penggabungan ke cabang utama tetap membutuhkan penalaran model terkuat. Mengorbankan ketelitian pada titik evaluasi demi menghemat token justru berujung pada kerugian finansial yang jauh lebih besar akibat lolosnya kode bermasalah ke lingkungan produksi.
Menetapkan Handoff Budget dan Mengisolasi Log Eksekusi
Setiap informasi yang dikembalikan oleh subagent akan menetap di dalam konteks agen induk dan dibaca ulang pada setiap giliran berikutnya. Laporan kerja sepanjang ratusan baris berisi riwayat eksekusi hanya akan menjadi beban konteks mahal. Oleh karena itu, penting memberlakukan kontrak pelaporan serah-terima (handoff budget) yang ketat.
Instruksikan subagent bekerja secara terisolasi di dalam repositori atau direktori kerja yang ditentukan, mengalihkan rekaman keluaran terminal ke berkas log di media penyimpanan lokal, dan hanya mengembalikan ringkasan padat maksimal 12 baris. Laporan tersebut cukup merinci berkas mana saja yang diubah, kode status pengujian yang dijalankan, serta kendala teknis tersisa. Bukti pelaksanaan tugas tetap tersimpan aman di berkas log fisik dan hanya dibuka oleh agen induk jika terjadi kegagalan eksekusi.
Kedisiplinan tata kelola alur kerja dan pencatatan audit terisolasi ini mengadopsi prinsip serupa dengan standar tata kelola ketat industri, seperti halnya perlindungan lingkungan data pada arsitektur proteksi dan audit sistem.
Konsolidasi Panggilan Latar Belakang dan Pembatasan Muatan Alat
Fungsi otomatisasi latar belakang (background hooks) sering berjalan tanpa disadari dan memakan porsi token signifikan. Kebiasaan memicu pemanggilan model pada setiap akhir giliran percakapan dapat menghasilkan ratusan transaksi mikro tidak efisien. Alih-alih memanggil model secara konstan, kumpulkan data aktivitas dan jalankan proses peringkasan berkala dalam interval waktu tertentu menggunakan model teringan. Pastikan data yang dikirimkan hanya berupa masukan pengguna dan respon akhir, tanpa menyertakan tumpukan keluaran alat mentah.
Selain itu, kegagalan eksekusi alat otomasi akibat muatan data terlalu besar juga menjadi sumber pemborosan tersembunyi. Ketika muatan skrip melampaui batas toleransi alat, kesalahan sistem memicu pengulangan perintah yang kembali membebani konteks. Memecah muatan eksekusi menjadi beberapa segmen kecil dan menerapkan mekanisme pengecekan status secara modular memastikan alur otomasi berjalan mulus tanpa siklus coba-ulang sia-sia.
Efisiensi Berkelanjutan Tanpa Mengorbankan Mutu
Optimalisasi konsumsi token bukanlah sekadar upaya memangkas biaya langganan, melainkan wujud kedewasaan dalam merancang arsitektur perangkat lunak berbasis kecerdasan buatan. Mengandalkan peningkatan kapasitas paket tanpa menata arsitektur konteks hanya menunda masalah, terutama ketika volume pekerjaan tim rekayasa meningkat masif.
Dengan menerapkan prinsip progressive disclosure pada berkas instruksi, membagi peran agen secara spesifik, menetapkan batas pelaporan subagent, dan mendistribusikan beban kerja secara proporsional ke berbagai tingkatan model, efisiensi konsumsi hingga 50 persen dapat tercapai konsisten. Yang terpenting, volume keluaran kode, kecepatan penyelesaian tiket, dan ketatnya standar kualitas perangkat lunak tetap terjaga pada standar tertinggi.